Pubblicato il
Paghi l'abbonamento premium, sei nel mezzo di un lavoro importante e Claude ti blocca la chat: limite raggiunto. Succede quasi a tutti, e quasi sempre non dipende da quanti messaggi hai mandato, ma da quanti token hai consumato.
Questa guida raccoglie i 7+1 trucchi per dominare i token in Claude: otto accorgimenti semplici, ognuno con un esempio concreto, per lavorare più a lungo consumando meno token.
Scarica la dispensaVersione PDF stampabile di questa lezione, con esercitazione e glossario.
Scarica la dispensa in PDFObiettivo
Capire che cosa consuma i token in Claude e applicare otto trucchi pratici per lavorare più a lungo, senza blocchi improvvisi e con meno spreco.
Che cosa saprai fare alla fine
- Spiegare perché il decimo messaggio di una chat costa molto più del primo.
- Resettare una chat lunga con un riassunto (il «reset della chat») e usare /compact in Claude Code.
- Correggere un errore con la matita invece di scrivere un nuovo messaggio.
- Sfruttare le sessioni da 5 ore e proteggere il Prompt Caching.
- Usare Progetti, plugin e modelli (Haiku, Sonnet, Opus) in modo mirato.
- Scrivere prompt brevi e concisi, senza perdere precisione.
Indice
- Perché Claude ti blocca la chat
- Trucco 1: resetta il contesto con un riassunto
- Trucco 2: riscrivi la storia invece di correggerla
- Trucco 3: avvia la sessione in anticipo per averne due
- Trucco 4: proteggi il Prompt Caching
- Trucco 5: usa i Progetti per i documenti che ti servono sempre
- Trucco 6: disattiva i plugin che non usi
- Trucco 7: scegli il modello giusto per il compito
- Trucco extra: scrivi prompt brevi e concisi
- La check-list in una pagina
- Esercitazione pratica
- Le domande che arrivano in aula
- Glossario
- Per approfondire
1. Perché Claude ti blocca la chat
Il blocco non dipende dai messaggi che invii: dipende da quanti token consumi.
Il modello non conta quanti messaggi mandi, conta quanto testo deve leggere e scrivere. L'unità di misura è il token, e un token equivale a poco meno di una parola.
Lavorare più a lungo consumando meno token.
1.1 Il decimo messaggio costa più del primo
Claude non legge mai solo la tua ultima frase. Per rispondere rilegge l'intera conversazione dall'inizio. Più avanzi nella chat, più token bruci soltanto per fargli rileggere il passato.
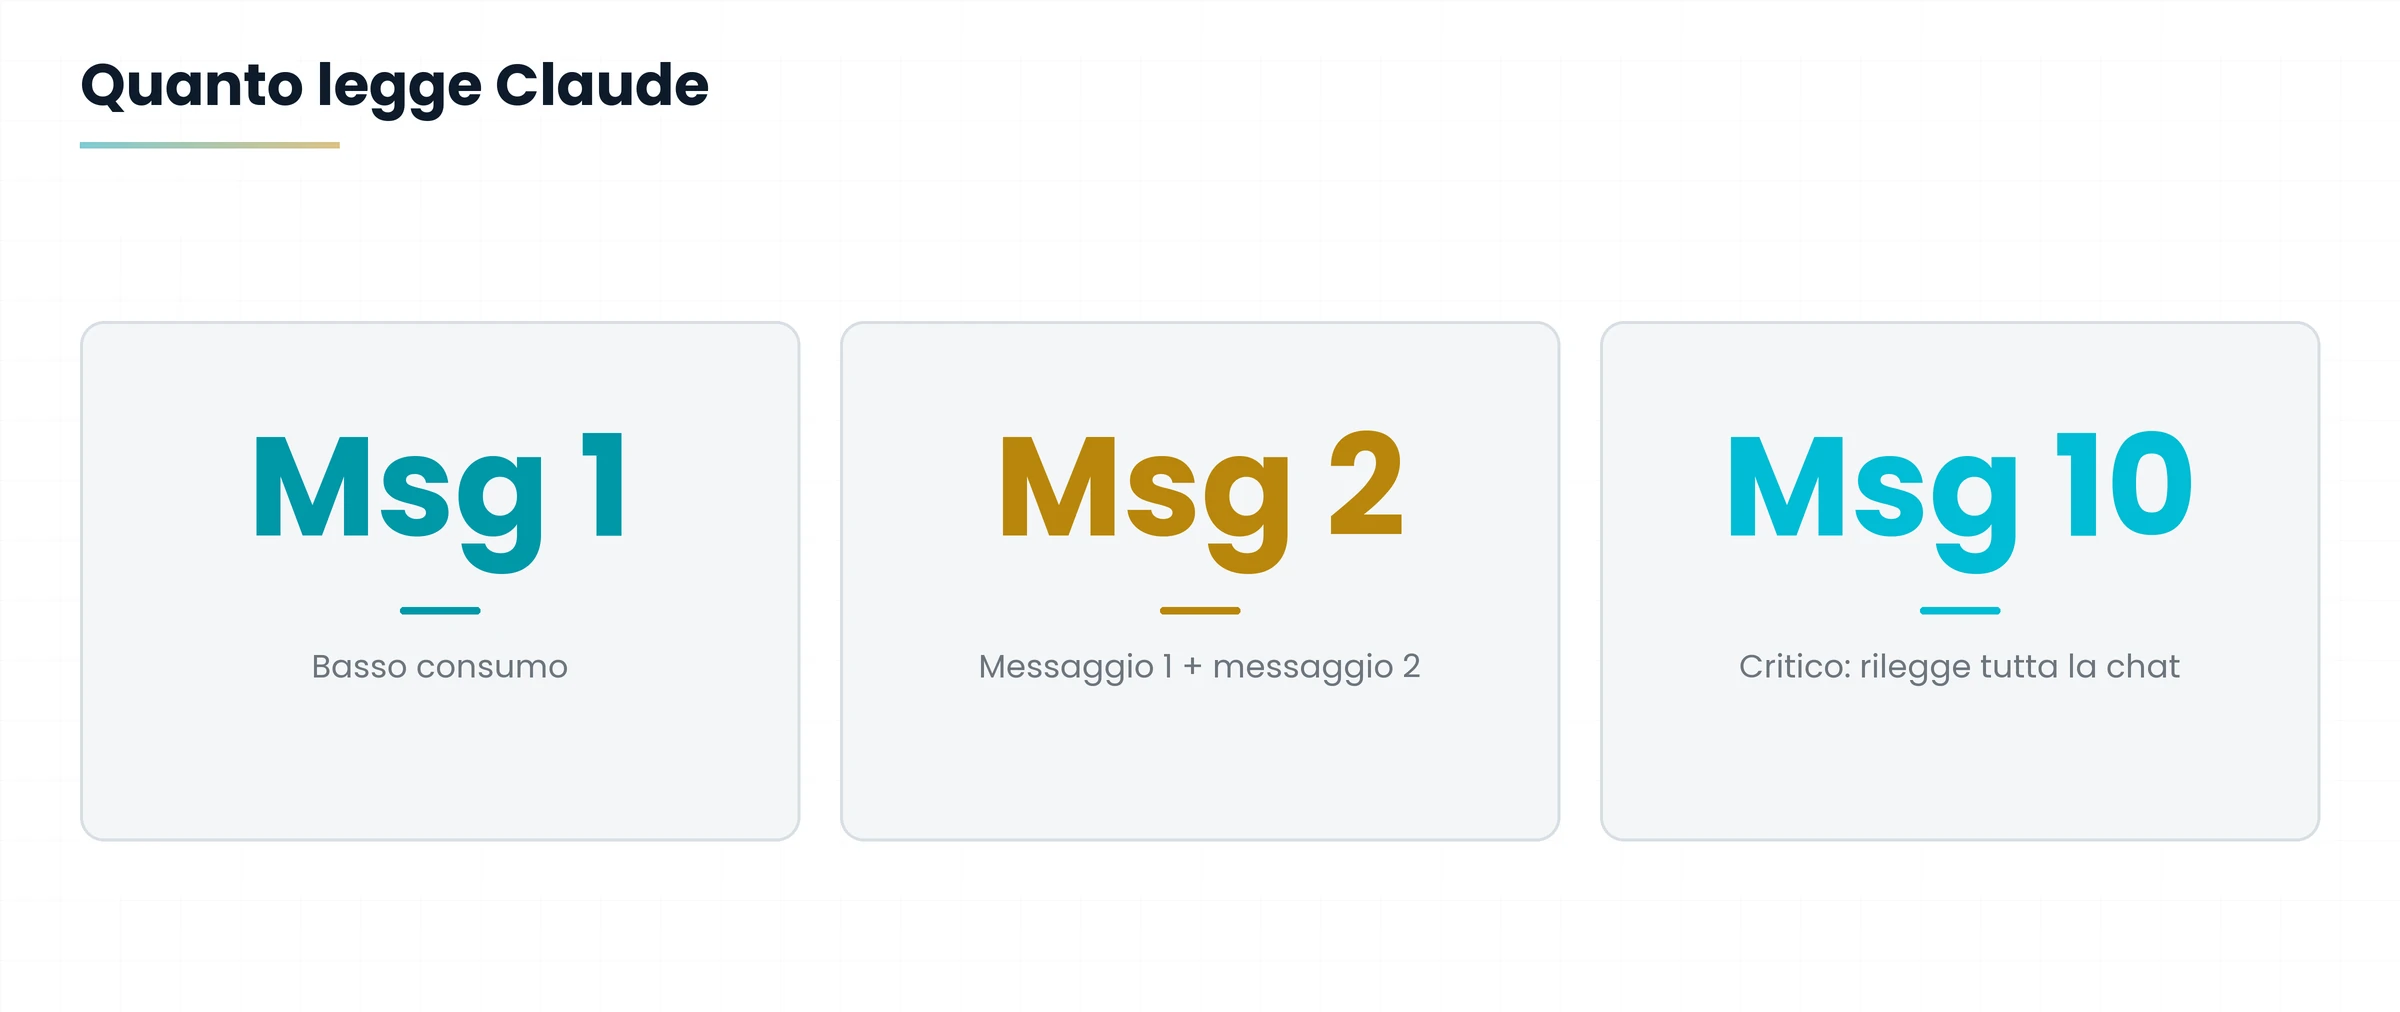
| Messaggio | Che cosa rilegge Claude | Consumo |
|---|---|---|
| Messaggio 1 | Solo il messaggio 1 | Basso |
| Messaggio 2 | Messaggio 1 + messaggio 2 | Più alto |
| Messaggio 5 | Tutti i messaggi dall'1 al 5 | Alto |
| Messaggio 10 | Tutti i messaggi dall'1 al 10 | Critico |
Stai preparando un'offerta commerciale e fai domande una dopo l'altra nella stessa chat: titolo, prezzi, condizioni, tono, correzioni.
Al decimo messaggio Claude deve rileggere anche tutte le bozze e le correzioni dei nove precedenti. La domanda è breve, ma il costo non lo è.
Più la chat è lunga, più ogni nuovo messaggio costa. Gli otto trucchi che seguono servono a spezzare questa spirale.
2. Trucco 1: resetta il contesto con un riassunto
Dopo 10-15 messaggi il consumo diventa critico: è il momento di staccare la chat e ripartire pulito.
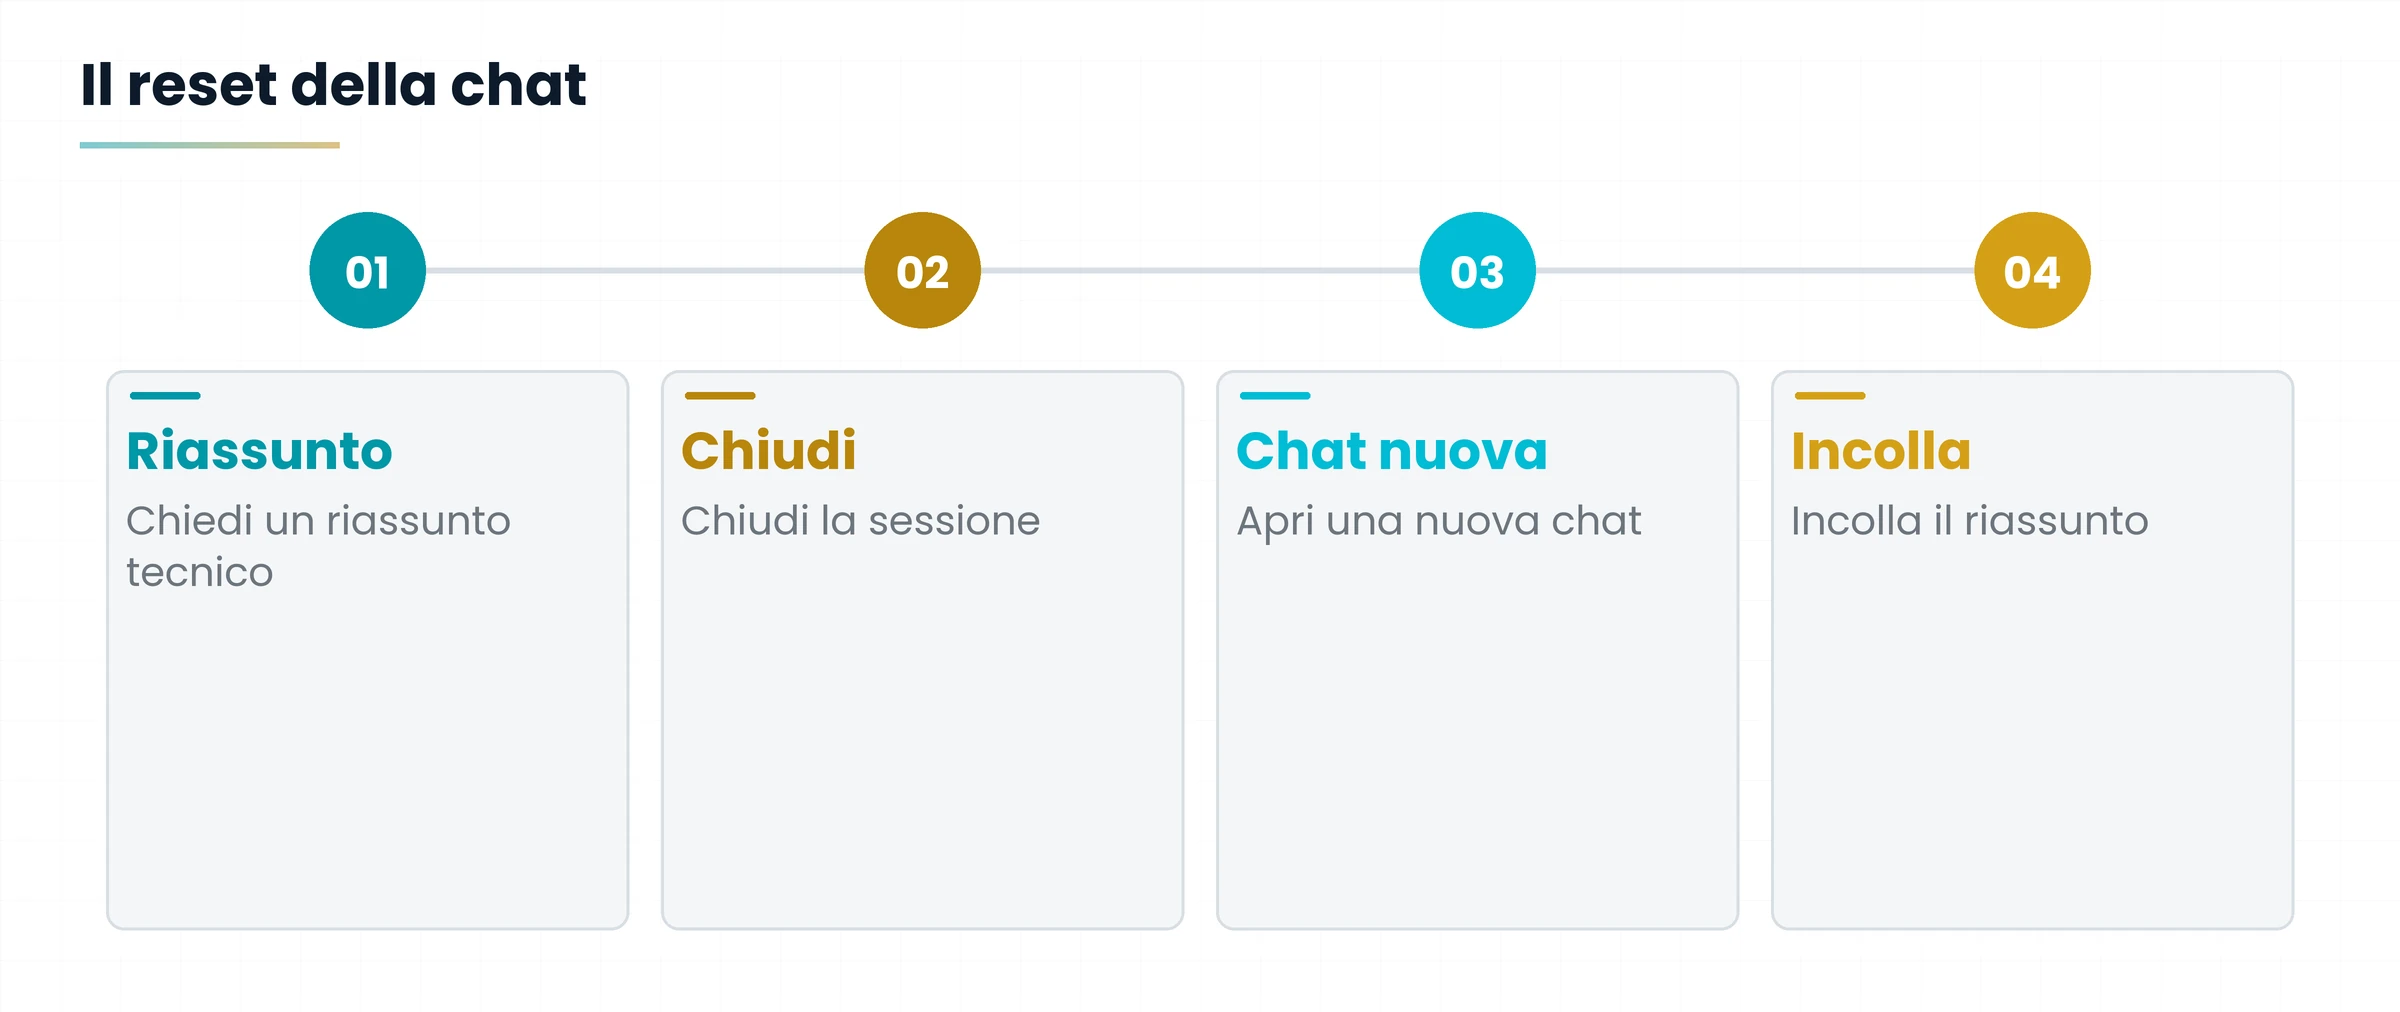
Il reset della chat azzera il peso della conversazione senza perdere il lavoro fatto: porti con te solo un riassunto, non tutta la storia.
- Chiedi a Claude un riassunto tecnico e dettagliato dell'intera chat.
- Chiudi la sessione attuale.
- Apri una nuova chat e incolla il riassunto: il contesto è ripristinato a costo quasi zero.
Alla chat lunga scrivi: «Riassumi in modo tecnico e dettagliato tutta la conversazione: obiettivo, decisioni prese, dati importanti, punti ancora aperti.»
Nella chat nuova incolli il riassunto e continui con la domanda successiva: «Partendo da qui, scrivi la bozza del punto 3.»
La funzione /compact esegue questa operazione automaticamente, di default.
3. Trucco 2: riscrivi la storia invece di correggerla
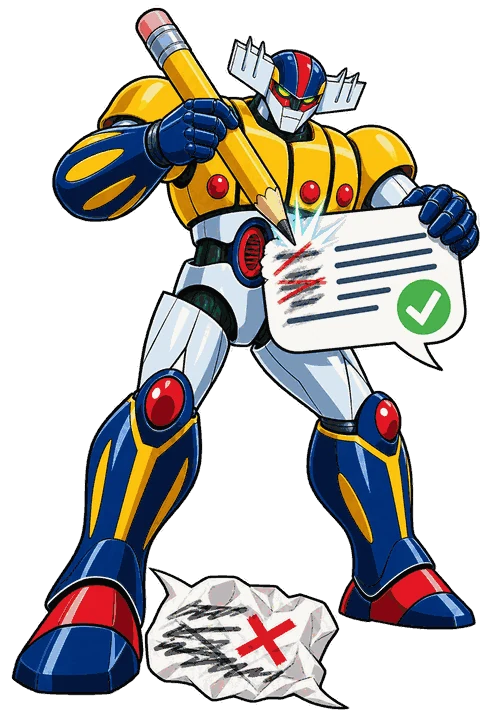
Quando Claude sbaglia, non rispondere «no, volevo un'altra cosa»: modifica il prompt originale con la matita.
3.1 L'errore da evitare
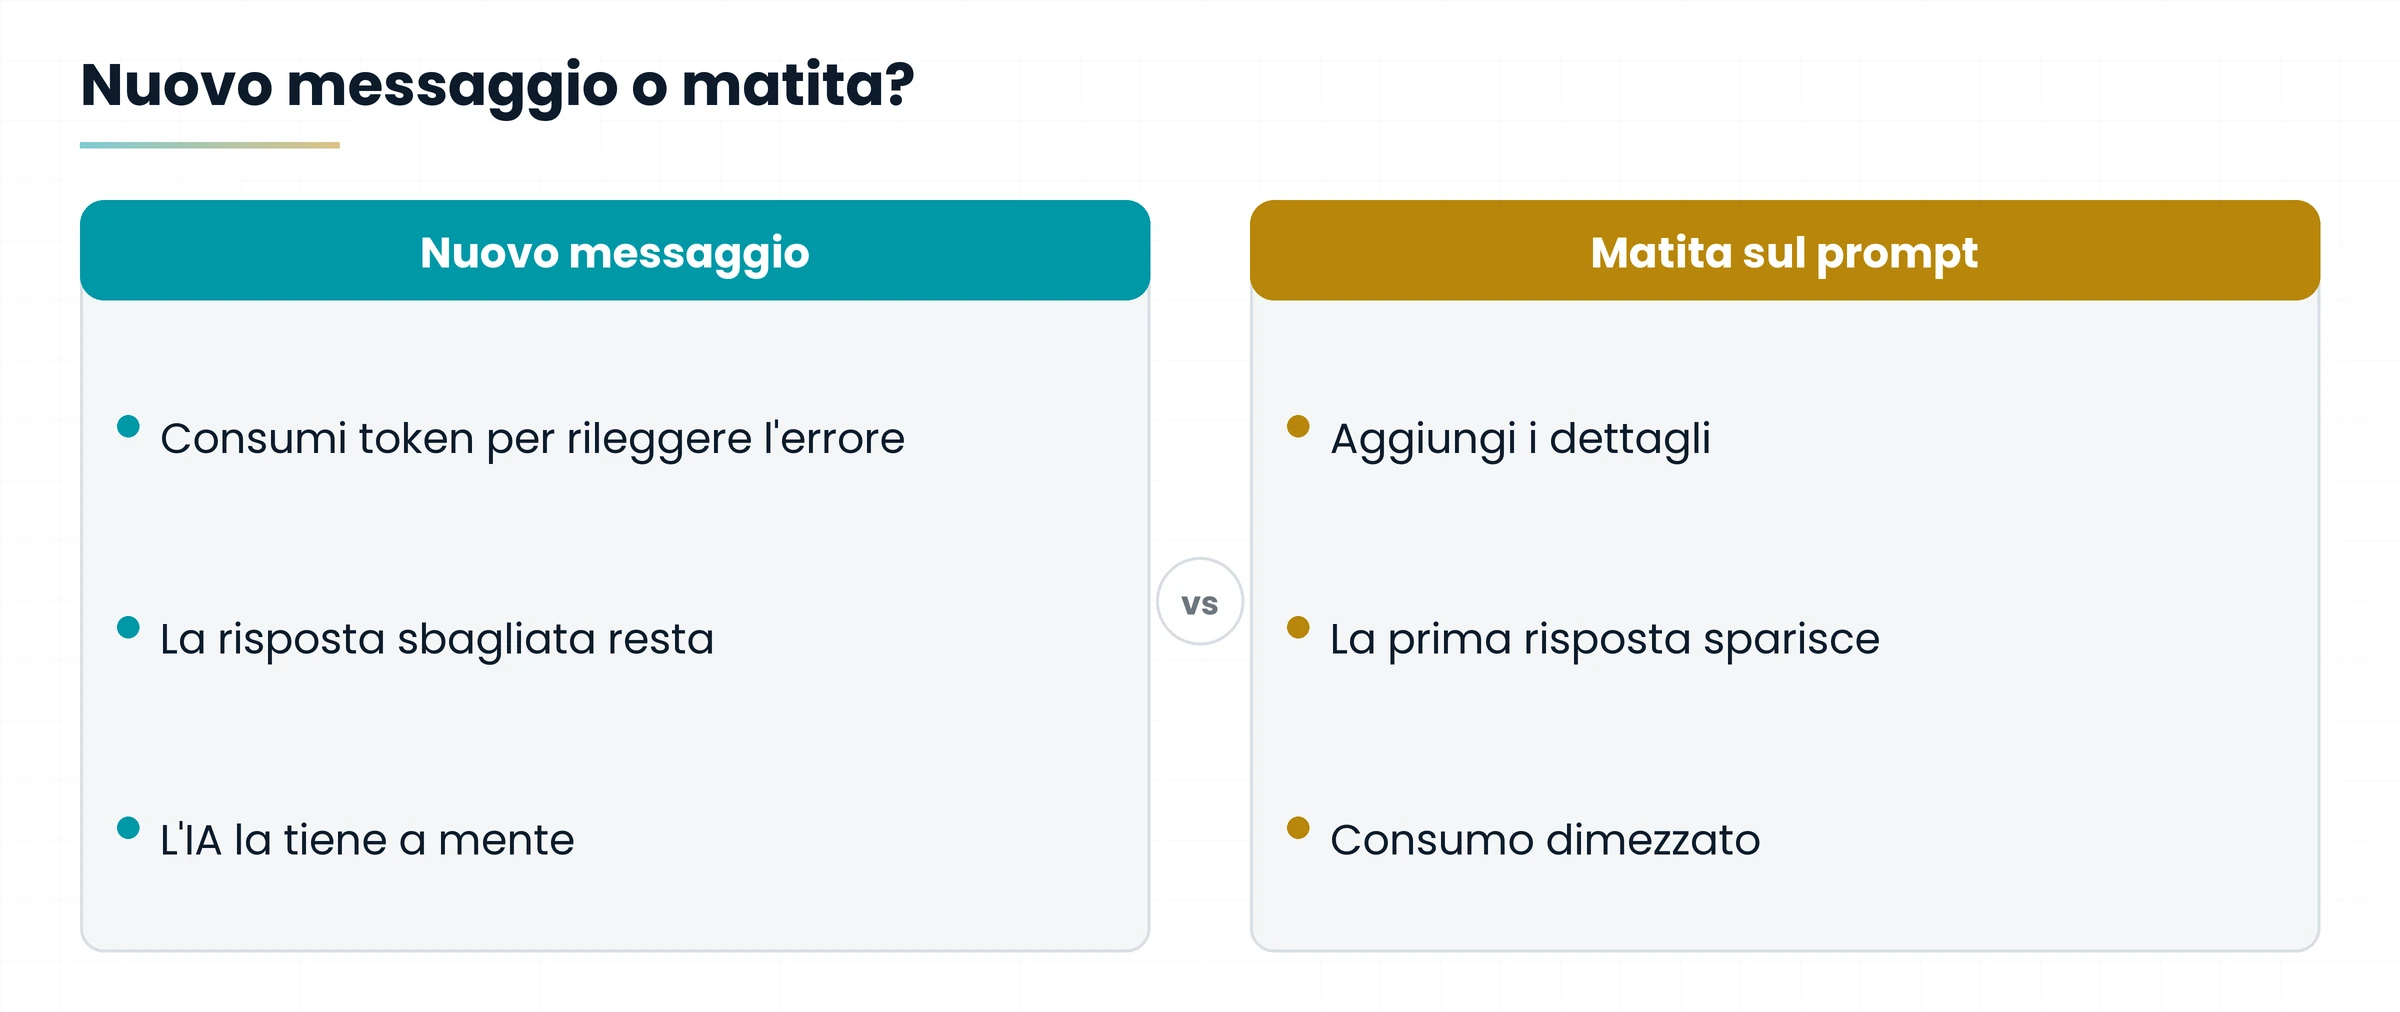
Inviare un nuovo messaggio del tipo «No, non intendevo questo, volevo X» ti fa consumare token per fargli rileggere l'errore. In più sporchi la memoria della chat: la risposta sbagliata resta lì e l'IA continuerà a tenerla a mente.
3.2 Il modo giusto
Clicca l'icona matita sul tuo prompt originale, aggiungi i dettagli mancanti e sovrascrivi. Claude cancella la prima risposta e ne genera una nuova: contesto pulito, consumo di token dimezzato.
Prompt originale: «Scrivi una mail per sollecitare un pagamento.» Claude risponde con un testo molto formale.
Sbagliato: scrivere «No, più amichevole e più corta» → la mail formale resta in chat e viene riletta a ogni messaggio.
Corretto: matita sul prompt originale → «Scrivi una mail per sollecitare un pagamento, tono amichevole, massimo 5 righe.» → la risposta vecchia sparisce.
4. Trucco 3: avvia la sessione in anticipo per averne due
Ogni sessione di lavoro ha un limite massimo di token e dura esattamente 5 ore dal primo messaggio inviato.
4.1 Approccio base e approccio avanzato
- Approccio base: inizi a lavorare alle 09:00, la sessione scade alle 14:00. Hai sfruttato una sola sessione utile.
- Approccio avanzato: imposti un'automazione (per esempio con Make o Co-work) che invia un semplice «Ciao» alle 06:00. La prima sessione parte prima e le successive si spostano di conseguenza.
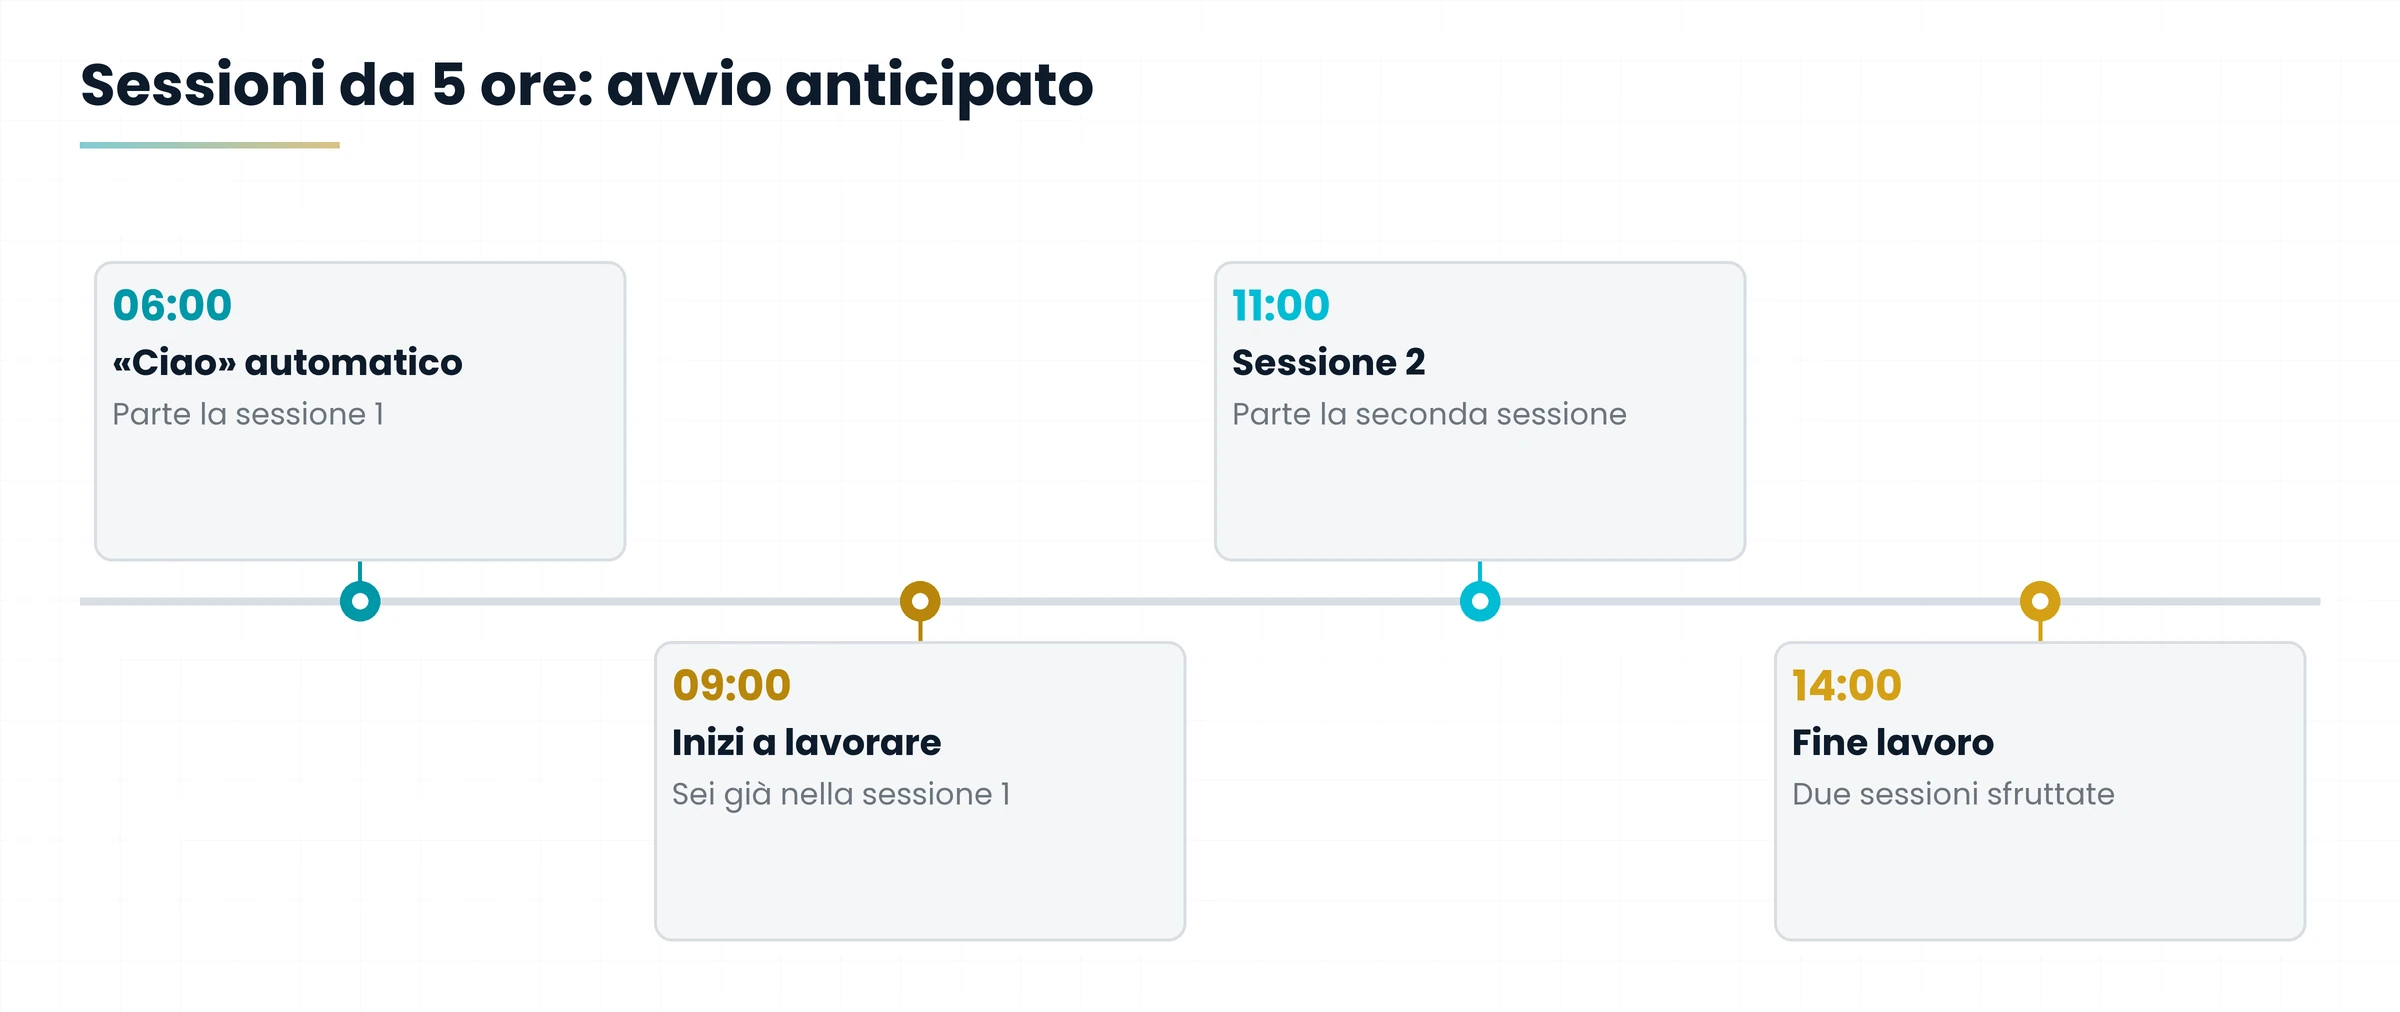
Lavori dalle 09:00 alle 14:00. Con l'avvio alle 06:00 la sessione 1 copre dalle 06:00 alle 11:00 e la sessione 2 parte alle 11:00: nel tuo orario di lavoro hai due sessioni di token invece di una.
Raddoppi i token giornalieri disponibili a parità di orario lavorativo, ma non alteri il cap settimanale.
5. Trucco 4: proteggi il Prompt Caching
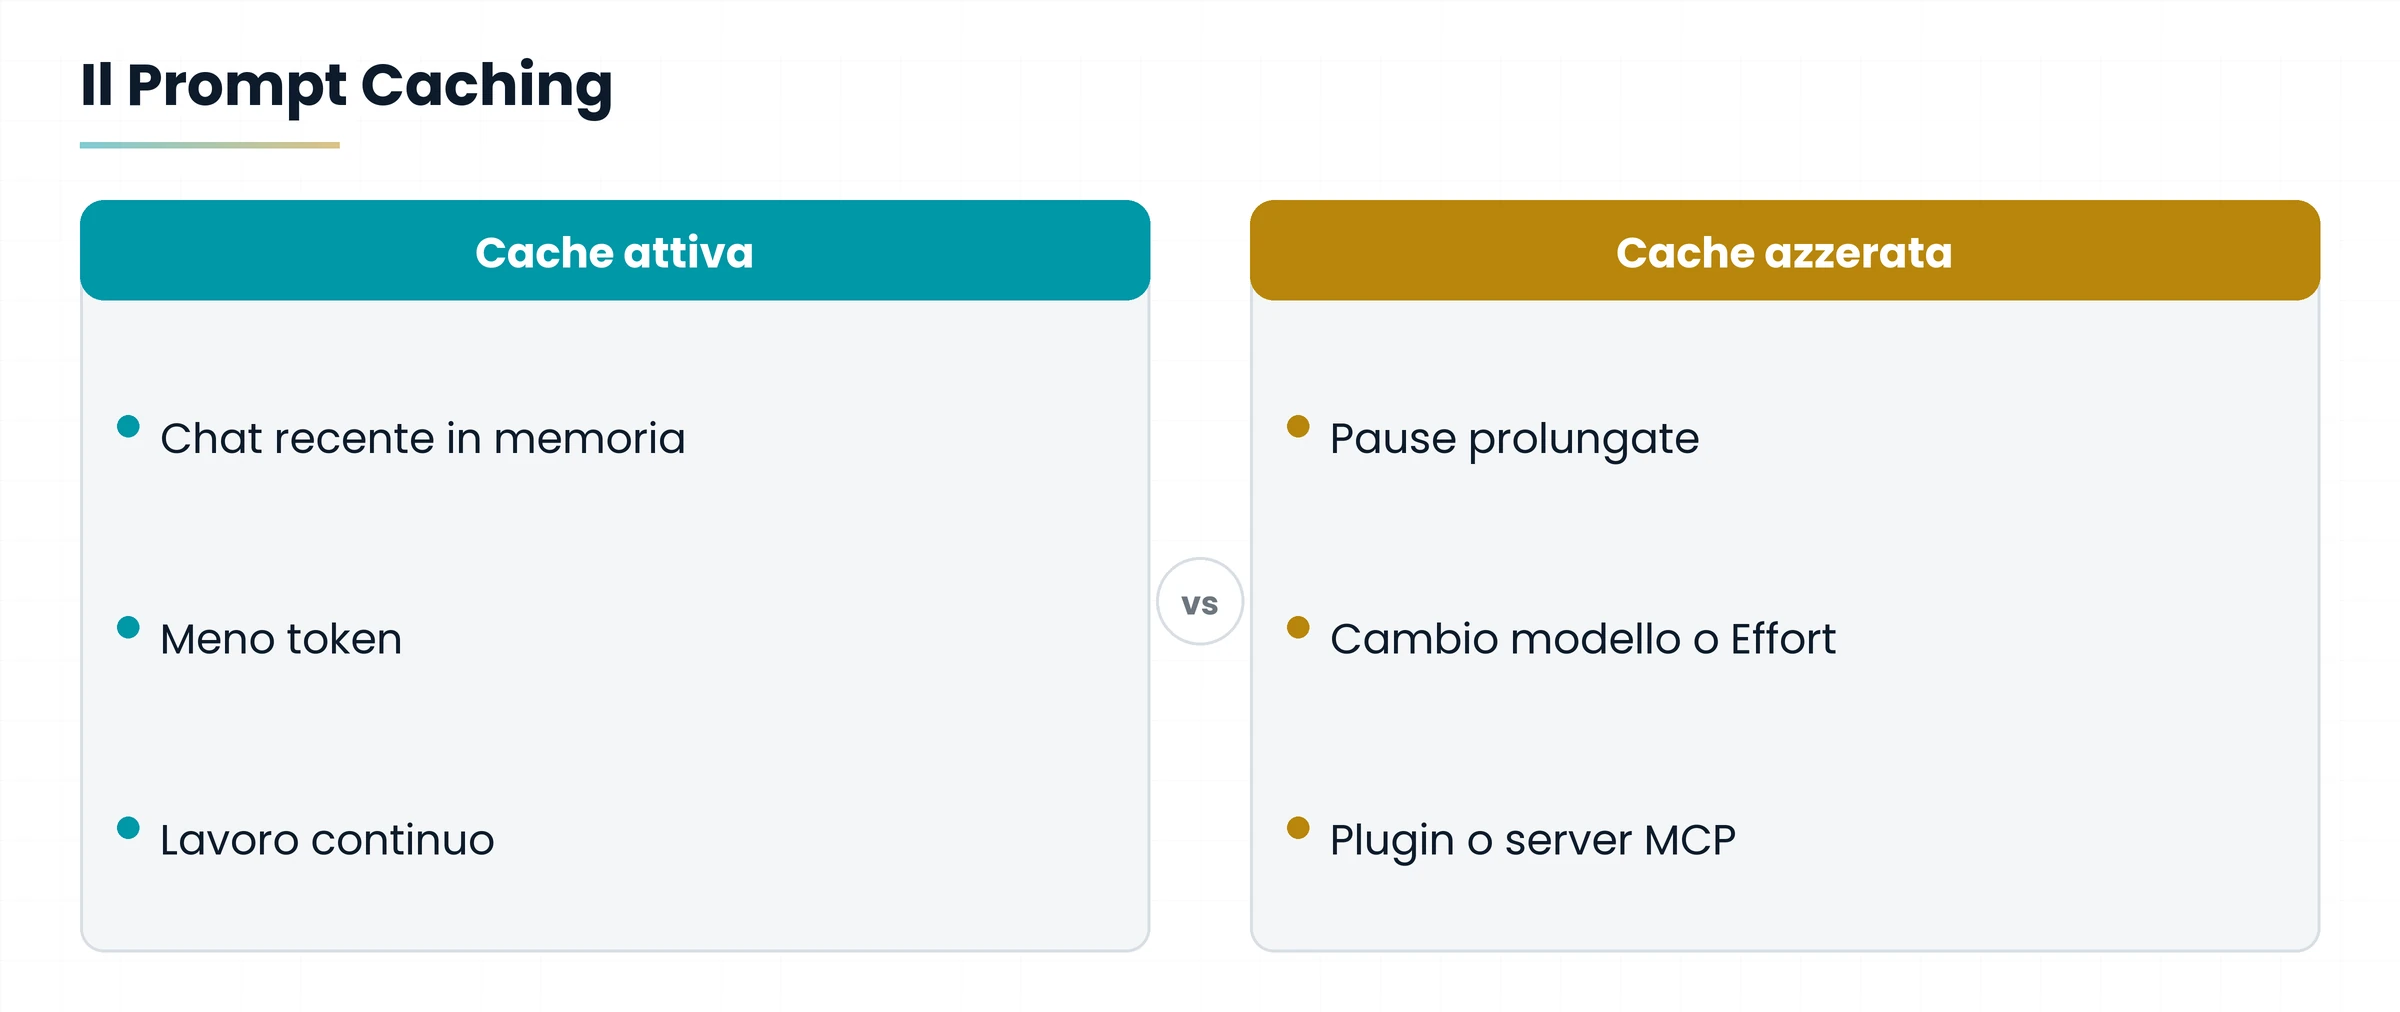
Claude non rilegge letteralmente tutto ogni volta: usa il Prompt Caching per tenere in memoria parti della chat recente.
- Il sistema: il Prompt Caching salva in memoria le parti della conversazione già elaborate. L'attivazione è automatica.
- Il vantaggio: ti fa risparmiare molti token sulle informazioni già processate.
- Il rischio: la cache è fragile e temporanea. Richiede un flusso di lavoro continuo.
5.1 Le azioni che azzerano la cache
Se compi una di queste azioni, la cache si azzera: Claude dovrà rileggere tutta la chat da zero e brucerai token all'istante.
- Pause temporali prolungate tra un messaggio e l'altro.
- Cambio del modello in corsa (per esempio da Sonnet a Opus).
- Modifica del livello di Effort richiesto al sistema.
- Collegamento o scollegamento di plugin o server MCP.
Hai una chat lunga su un'analisi. Vai a pranzo, torni dopo molto tempo e al secondo messaggio passi da Sonnet a Opus.
Hai azzerato la cache due volte in un colpo: Claude rilegge tutto da capo. Meglio: scegli modello e impostazioni prima di iniziare e lavora a blocchi continui.
6. Trucco 5: usa i Progetti per i documenti che ti servono sempre
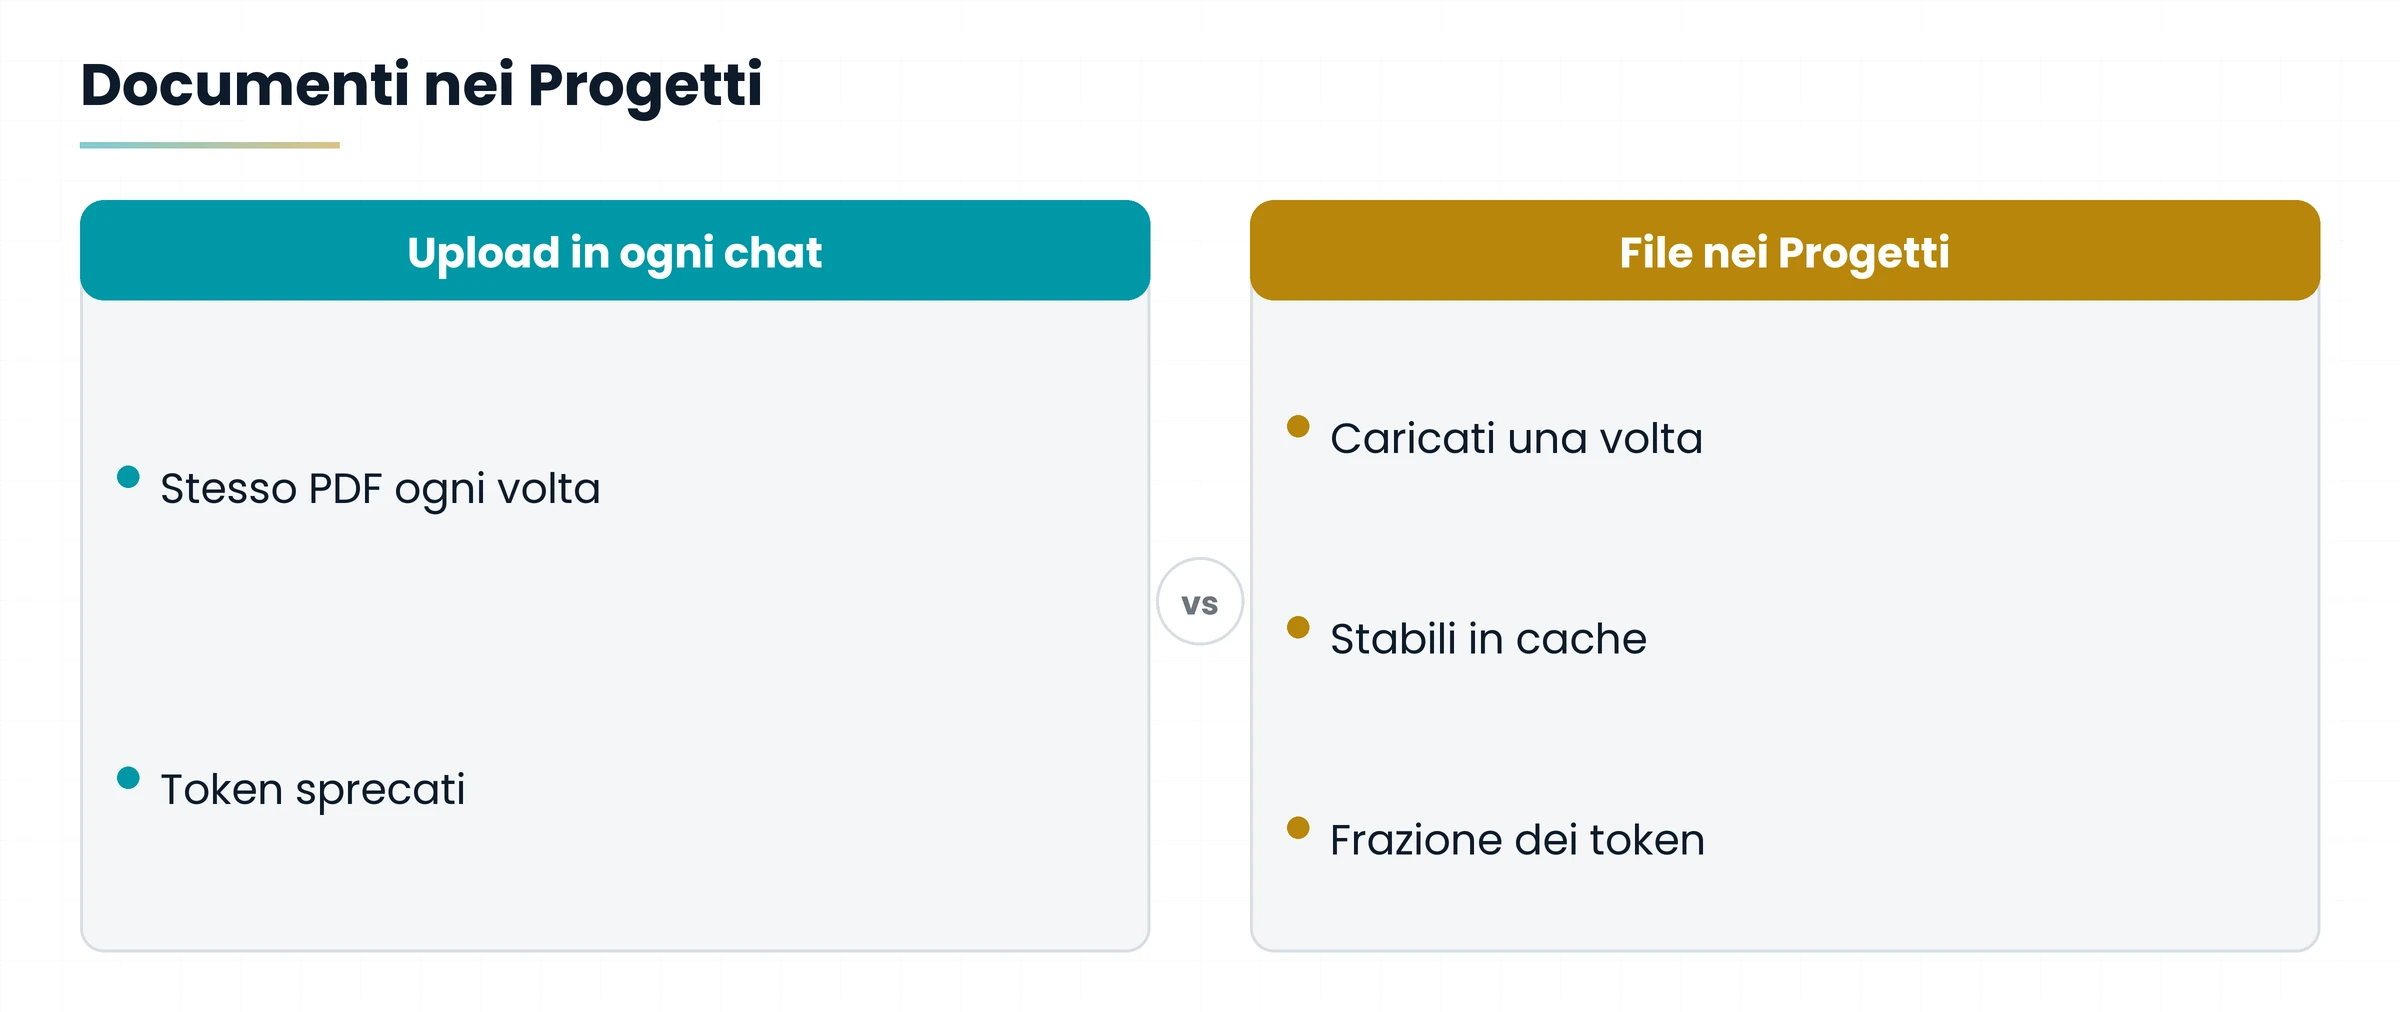
Caricare lo stesso file in ogni chat consuma token inutilmente: i documenti ricorrenti vanno nei Progetti.
- Procedura standard (da evitare): caricare manualmente lo stesso PDF in ogni singola chat.
- Procedura consigliata: carica documenti e linee guida ricorrenti nella funzione Progetti.
- Il vantaggio: i file nei Progetti restano stabilmente in cache. Interrogarli costa solo una minima frazione dei token rispetto al caricamento manuale transitorio.
Ogni settimana prepari preventivi e ti serve sempre lo stesso listino in PDF, più le linee guida di stile dell'azienda.
Invece di ricaricarli in ogni chat, creali una volta nel Progetto «Preventivi» e apri lì tutte le nuove conversazioni.
7. Trucco 6: disattiva i plugin che non usi
Ogni strumento attivo carica istruzioni invisibili nel contesto della chat, anche quando non lo usi.
L'errore classico è tenere tutti i plugin e i server MCP attivi di default, «perché non si sa mai». In realtà ogni strumento acceso consuma token preziosi in background, in modo totalmente inutile.
Disattiva tutto ciò che non è strettamente necessario per il lavoro che stai facendo.
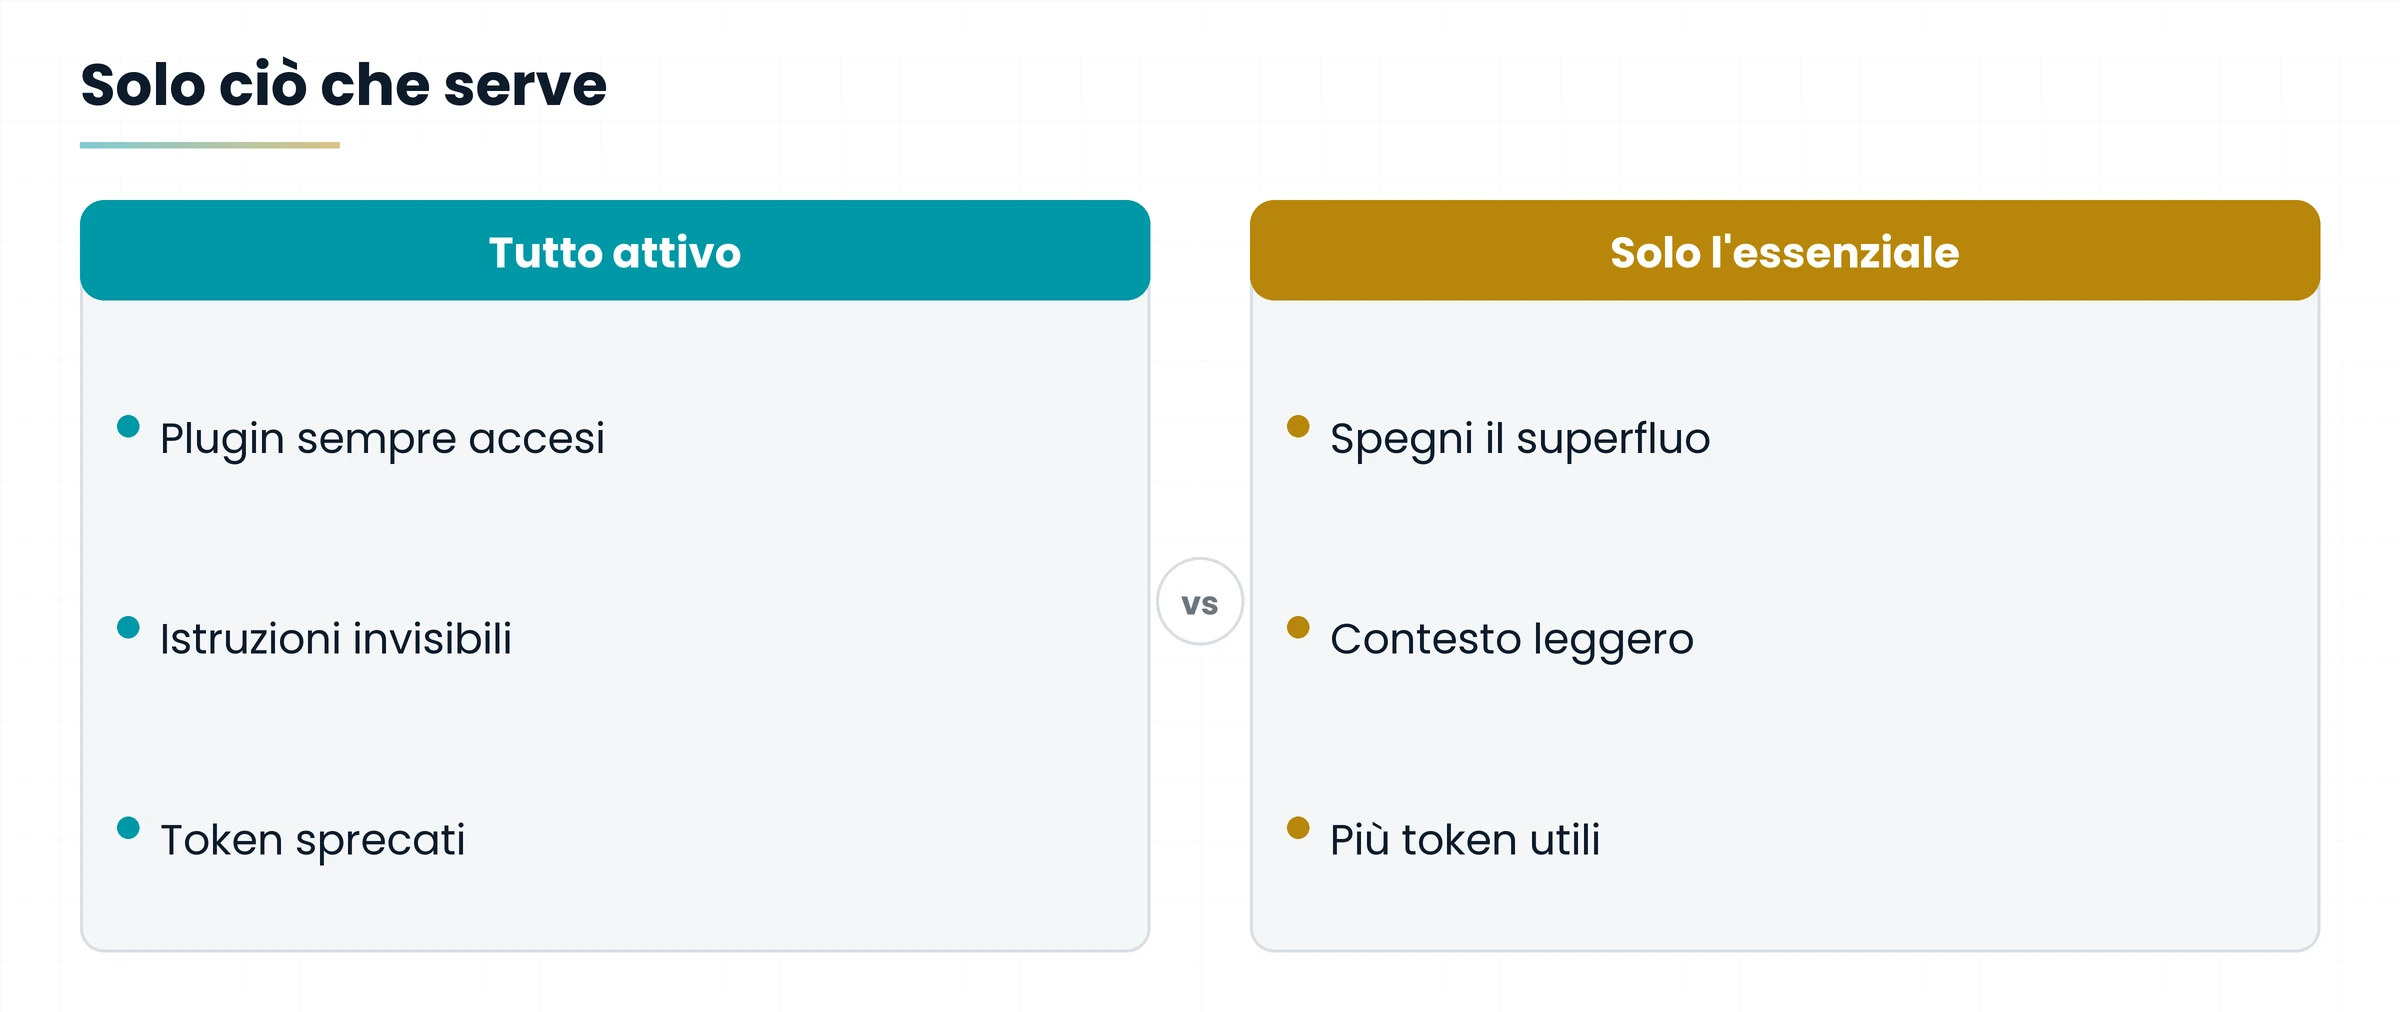
Devi solo correggere un testo, ma hai attivi tanti plugin e server MCP di altri progetti.
Spegni quelli che non servono prima di aprire la chat: lavori con un contesto più leggero. Ricorda che collegare o scollegare strumenti a chat avviata fa cadere la cache (Trucco 4).
8. Trucco 7: scegli il modello giusto per il compito
Non usare il modello più potente per un compito semplice: Haiku è la scelta giusta per consumare meno token.
| Modello | Quando usarlo | Consumo di token |
|---|---|---|
| Opus / Sonnet | Programmazione complessa, analisi profonda, ragionamento logico | Altissimo |
| Haiku | Correzioni grammaticali, traduzioni, riscritture veloci, task ripetitivi | Minimo |
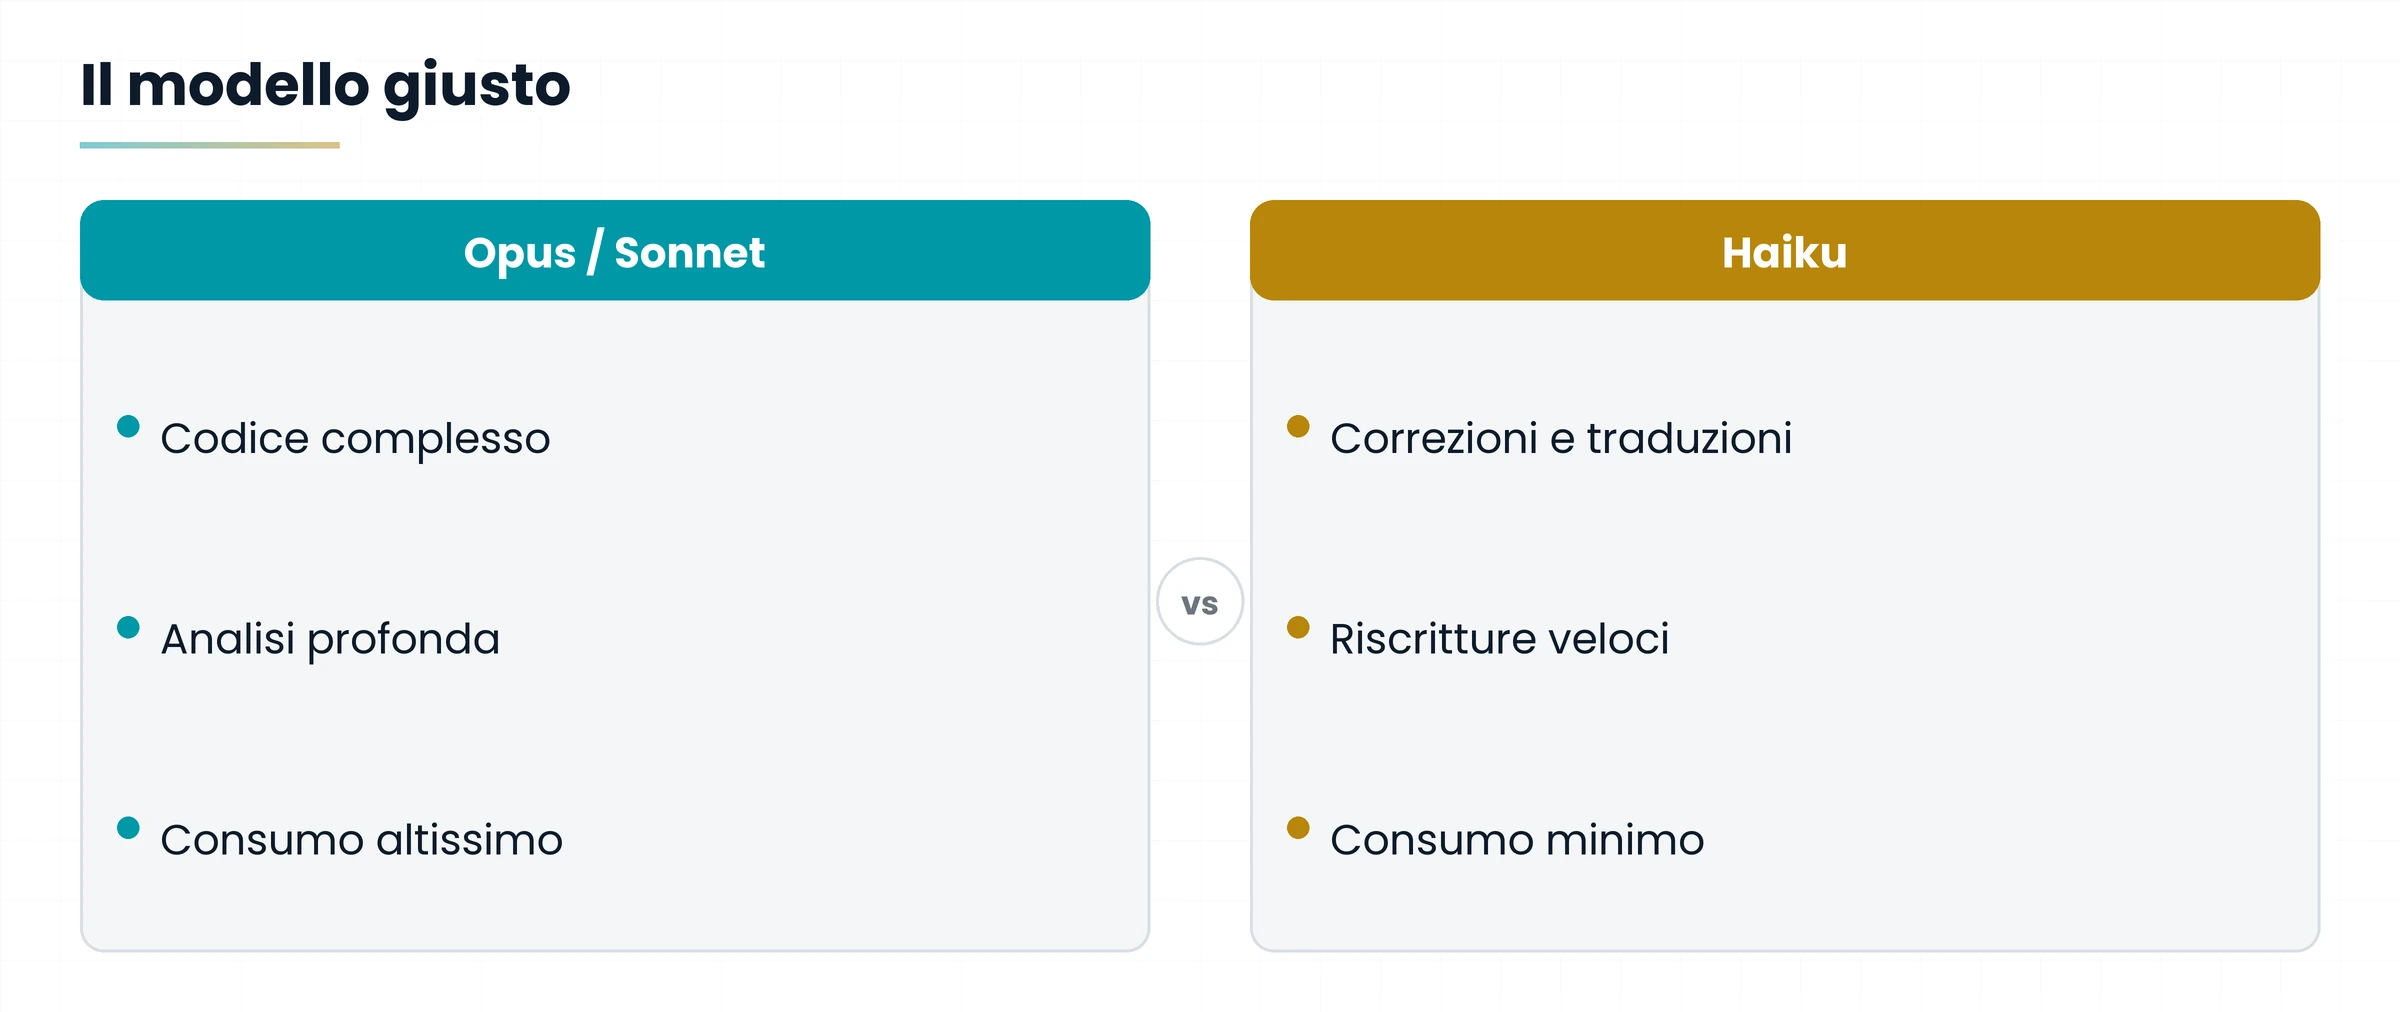
Haiku: correggere gli errori di una mail, tradurre un paragrafo, riscrivere una frase più chiara.
Sonnet o Opus: scrivere una funzione complessa, analizzare un contratto, ragionare su un problema logico a più passaggi.
Ricorda: il modello si sceglie a inizio chat, perché cambiarlo in corsa fa cadere la cache (Trucco 4).
9. Trucco extra: scrivi prompt brevi e concisi
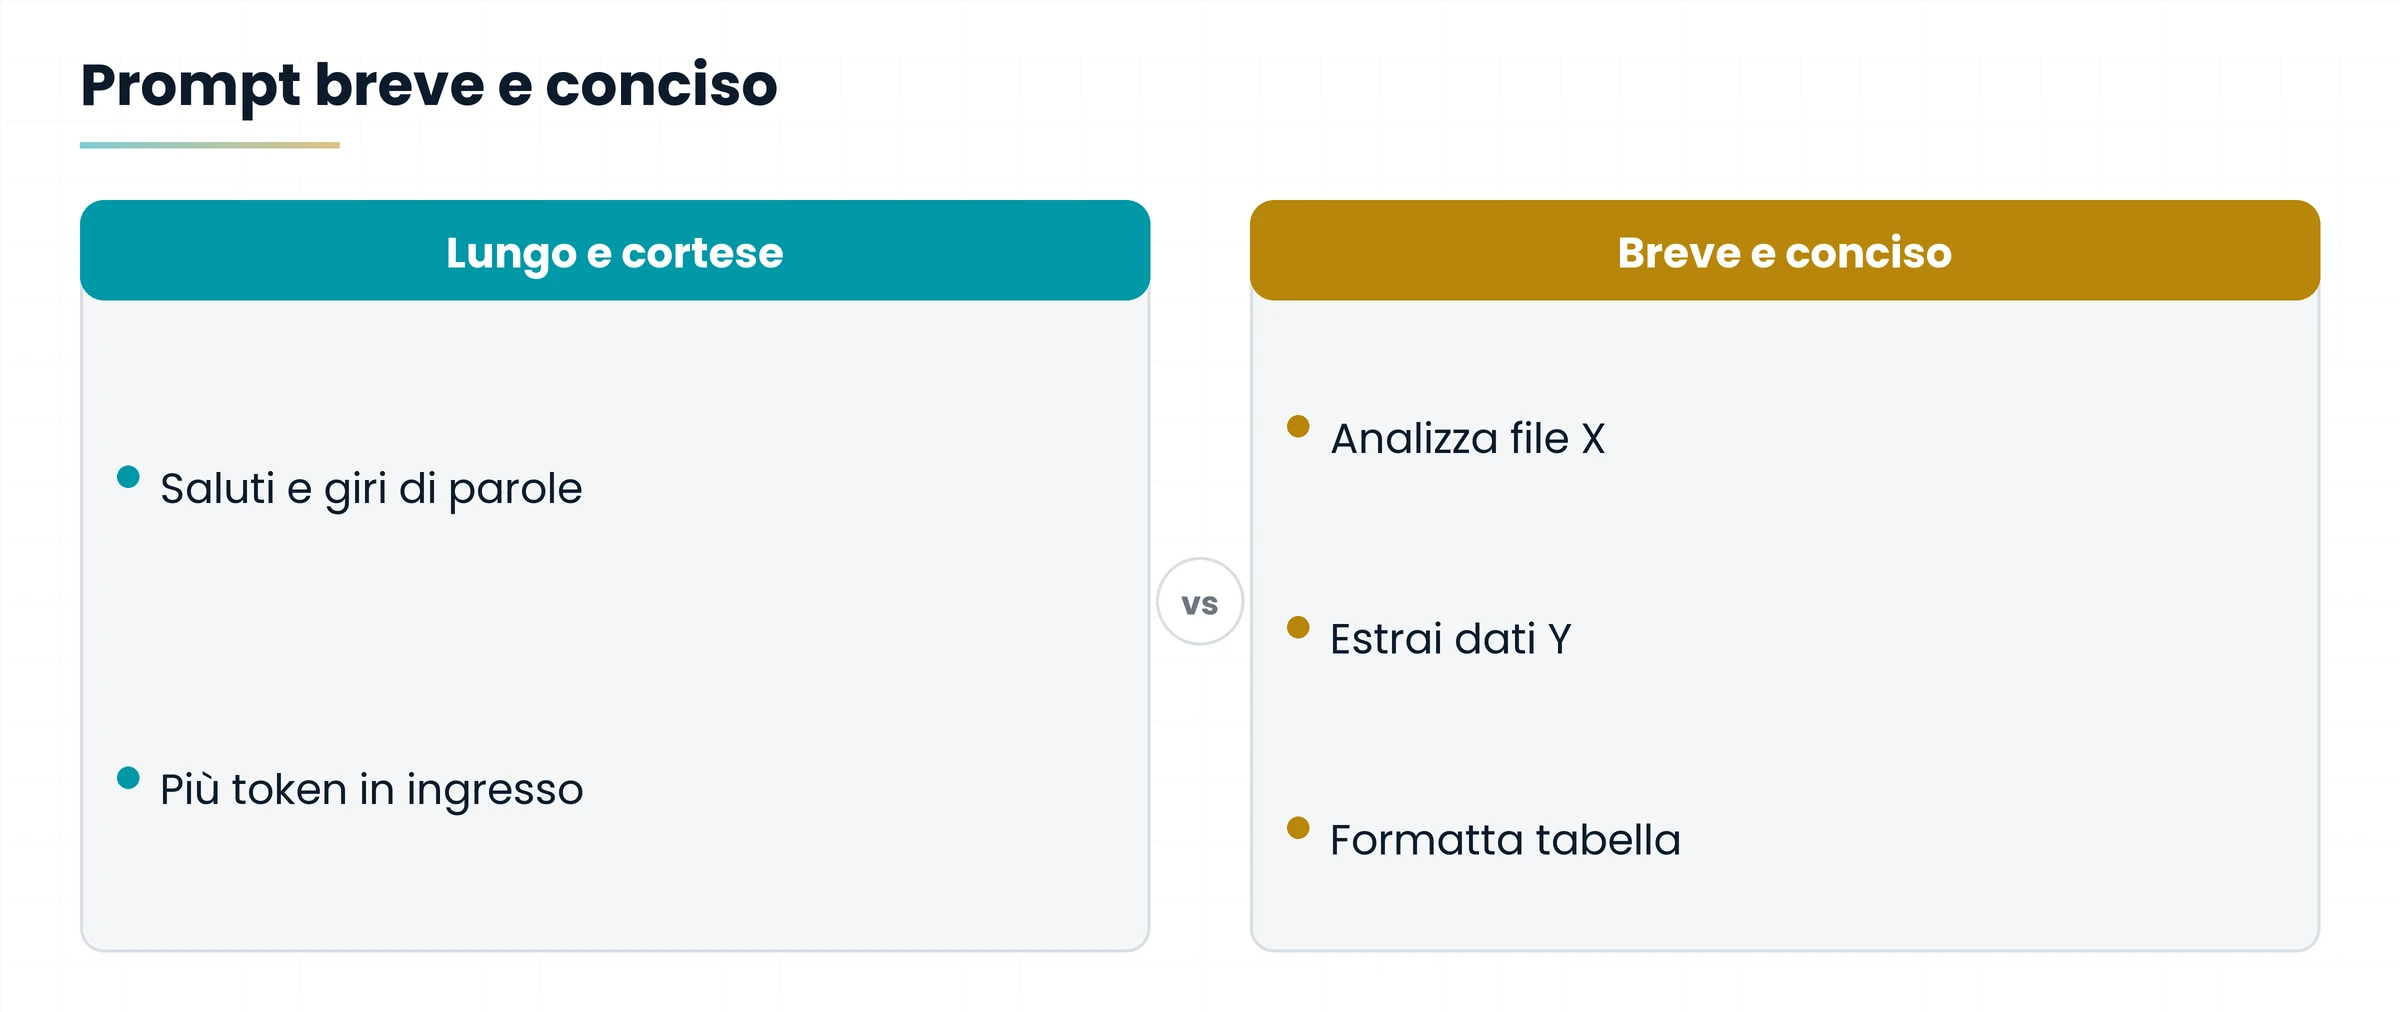
L'IA non ha sentimenti e non si offende: elimina cortesia, fronzoli e sintassi complessa. Meno parole digiti in input, meno token consumi.
| Prompt | Esempio |
|---|---|
| Lungo e cortese (spreco) | «Ciao Claude, saresti così gentile da leggere questo file e poi farmi una tabella per favore?» |
| Breve e conciso (efficienza) | «Analizza file X. Estrai dati Y. Formatta tabella.» |
9.1 Altri esempi concreti
- Invece di «Potresti per favore tradurre questo testo in inglese, se non è un disturbo?» scrivi: «Traduci in inglese.»
- Invece di «Vorrei un riassunto di questo documento, magari non troppo lungo» scrivi: «Riassumi in 5 punti.»
- Invece di «Mi aiuteresti a correggere gli errori di questo paragrafo?» scrivi: «Correggi errori.»
Taglia la cortesia, non le informazioni: obiettivo, file e formato del risultato devono restare chiari.
10. La check-list in una pagina
Gli otto trucchi in un colpo d'occhio: stampala e tienila accanto alla tastiera.
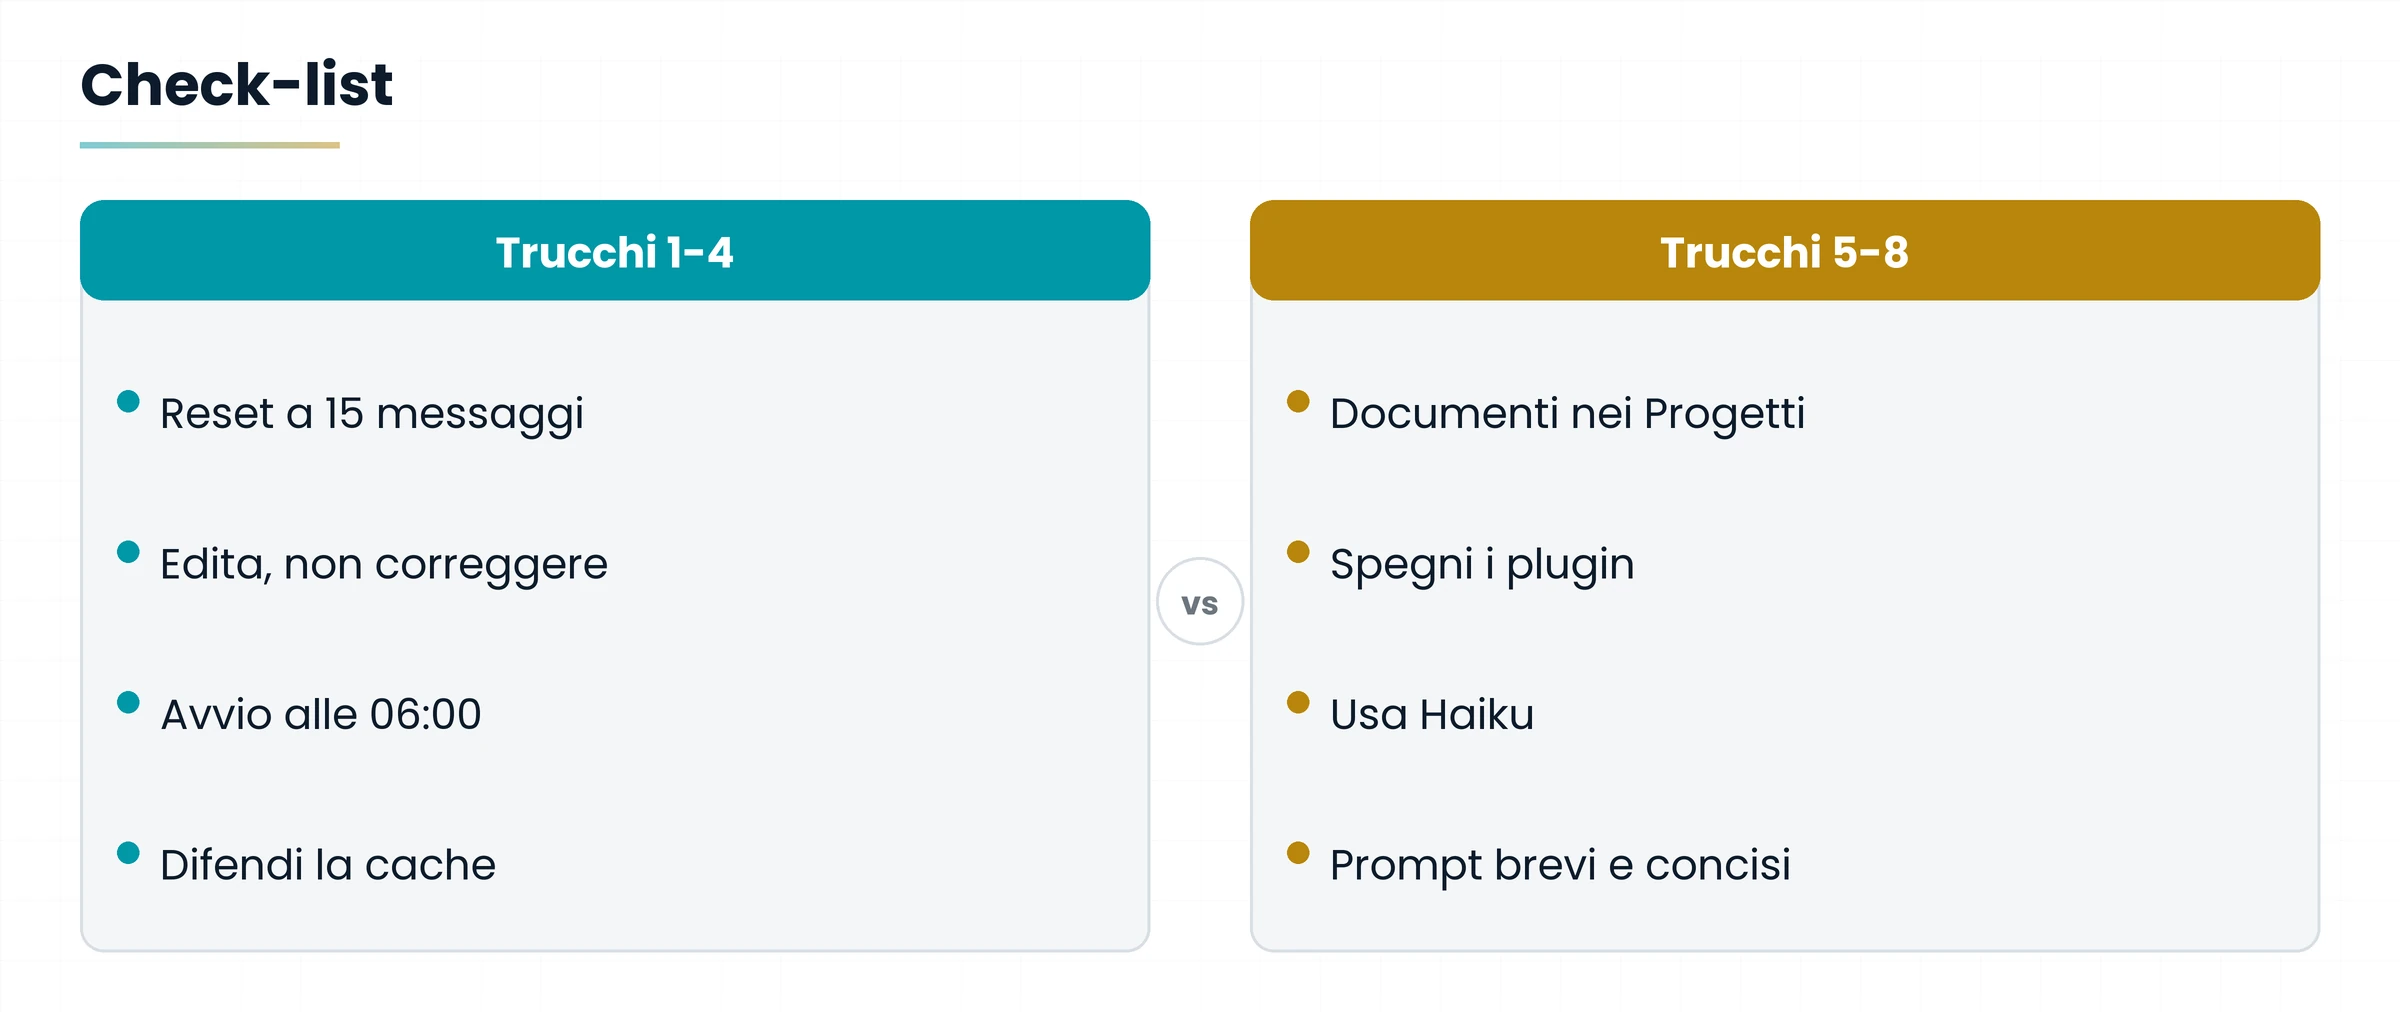
- Reset a 15 messaggi (usa i riassunti).
- Edita, non correggere (usa la matita).
- Avvio anticipato alle 06:00 (raddoppia le sessioni).
- Difendi la cache (evita pause e cambi di impostazioni).
- Documenti nei Progetti (basta upload ripetuti).
- Spegni i plugin (spegni i server MCP inattivi).
- Usa Haiku (per i micro-task quotidiani).
- Prompt brevi e concisi (zero fronzoli, massima resa).
Gestendo meglio il lavoro riuscirai a ottimizzare le spese e ad aumentare l'efficienza.
Esercitazione pratica
Quindici minuti, Claude aperto e una tua chat recente e lunga.
- Conta i messaggi della chat: sono più di 10-15? Se sì, chiedi a Claude un riassunto tecnico e dettagliato.
- Apri una chat nuova, incolla il riassunto e prosegui il lavoro.
- Trova una risposta che non ti convinceva e correggila con la matita sul prompt originale.
- Riscrivi un tuo prompt lungo e cortese in forma breve e concisa (come «Analizza file X. Estrai dati Y. Formatta tabella.»).
- Controlla plugin e server MCP attivi e spegni quelli che non ti servono per il lavoro di oggi.
- Scegli un compito semplice (una traduzione, una correzione) e provalo con Haiku.
Hai ripartito da una chat nuova con un riassunto?
Hai usato la matita invece di un messaggio di correzione?
Hai riscritto almeno un prompt in forma breve e concisa?
Le domande che arrivano in aula
Quanti messaggi posso fare in una chat prima di ripartire?
La regola pratica è 10-15 messaggi: oltre questa soglia il consumo diventa critico. A quel punto chiedi un riassunto e apri una chat nuova.
Perché dopo un'ora di pausa la chat consuma di più?
Perché la cache del Prompt Caching è temporanea: dopo una pausa prolungata la cache si azzera e Claude deve rileggere tutta la chat da zero.
L'avvio anticipato alle 06:00 aumenta anche il limite settimanale?
No. Raddoppia i token giornalieri disponibili a parità di orario di lavoro, ma non altera il cap settimanale.
Meglio la matita o un nuovo messaggio per correggere?
La matita: cancella la prima risposta e ne genera una nuova, con contesto pulito e consumo di token dimezzato.
Un prompt breve e conciso peggiora la risposta?
No, se resta preciso: taglia cortesie e giri di parole, ma lascia obiettivo, file e formato del risultato.
Glossario
| Termine | Che cosa significa |
|---|---|
| /compact | Funzione di Claude Code che esegue in automatico il reset della chat. |
| Effort | Livello di impegno richiesto al sistema: cambiarlo a chat avviata azzera la cache. |
| Haiku, Sonnet, Opus | I modelli di Claude: Haiku è leggero, Sonnet e Opus sono pesanti e consumano molto di più. |
| Plugin e server MCP | Strumenti collegati a Claude: se attivi caricano istruzioni invisibili nel contesto. |
| Progetti | Funzione che conserva file e linee guida ricorrenti, mantenuti stabilmente in cache. |
| Prompt Caching | Memoria temporanea che salva le parti recenti della chat e fa risparmiare token. |
| Reset della chat | Riassumere la chat, chiuderla e ripartire in una chat nuova incollando il riassunto. |
| Sessione | Finestra di lavoro con un limite massimo di token: dura 5 ore dal primo messaggio inviato. |
| Token | L'unità di consumo dell'IA: equivale a poco meno di una parola. |
Per approfondire
- Gianluca Bonomo, Niente paura, è solo IA — il libro di riferimento
Funzioni, nomi dei menu, limiti e modelli cambiano spesso: controlla sempre la versione di Claude che usi. Per approfondire, il libro di riferimento è «Niente paura, è solo IA».
Scarica la dispensaVersione PDF stampabile di questa lezione, con esercitazione e glossario.
Scarica la dispensa in PDF